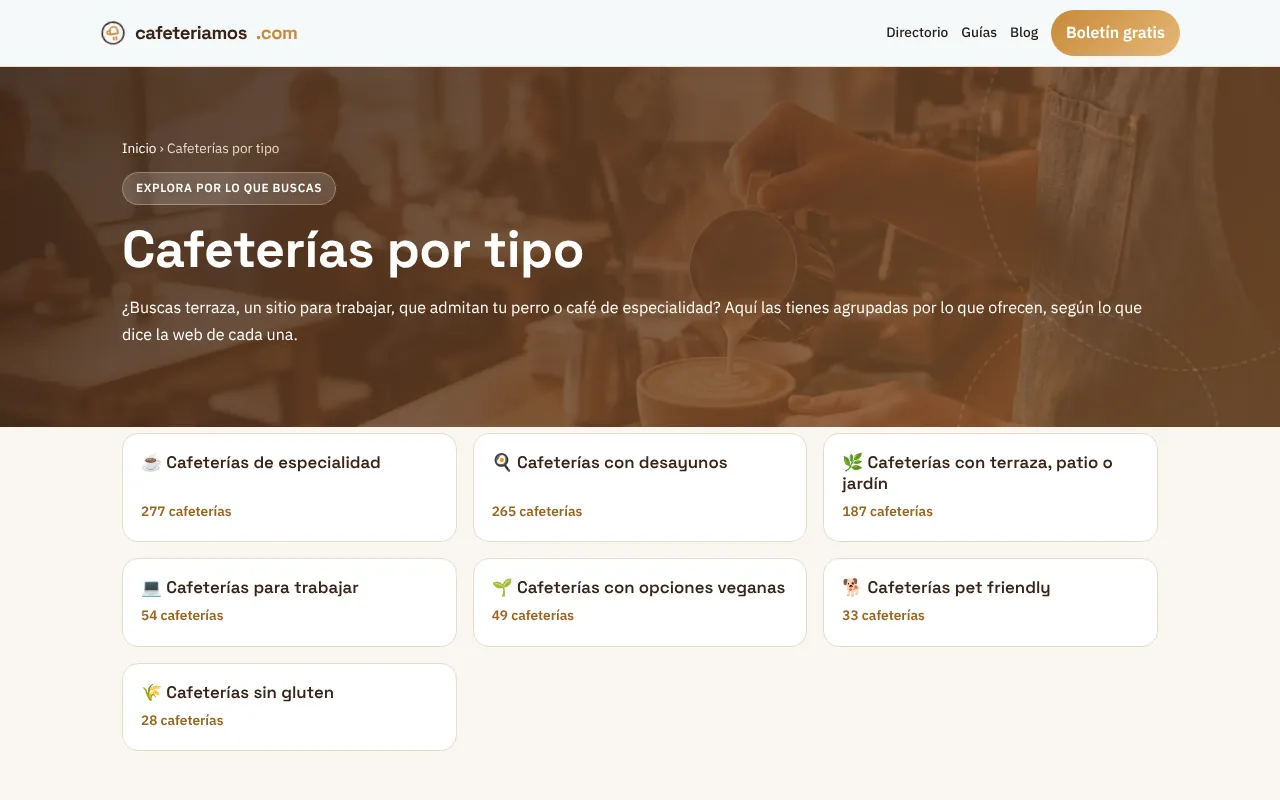
Todos los directorios que salen del mismo dataset de Google se parecen: nombre, valoración, dirección y teléfono. Lo que la gente busca de verdad es otra cosa: una cafetería con terraza, un sitio donde trabajar con el portátil, un restaurante sin gluten, un psicólogo que atienda online. Ese dato no está en Google, pero sí en la web de cada negocio. Este playbook explica cómo lo extraemos con Claude y cómo lo convertimos en páginas que la competencia no puede copiar.
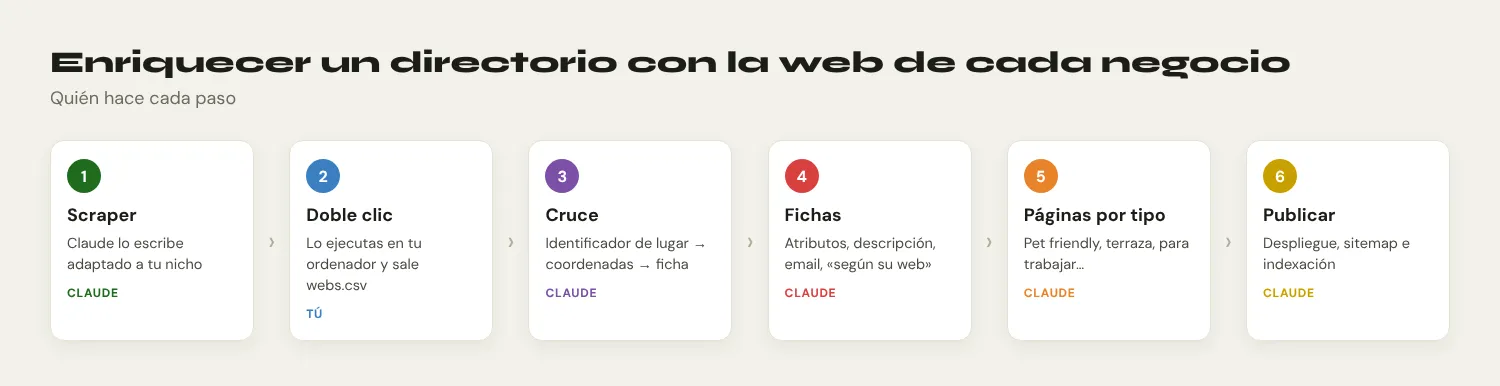
Respuesta corta: Claude escribe un scraper adaptado a tu sector que corres tú en tu ordenador con doble clic. Descarga la portada de cada negocio, extrae descripción, email, atributos (terraza, wifi, pet friendly…) y servicios, y escribe un CSV. Claude cruza ese CSV con tus fichas, las enriquece citando «según su web» y genera páginas por atributo (nacionales y por ciudad) enlazadas desde cada ficha.
El enlace para tu Claude
Abre una conversación nueva y pega esto, cambiando lo que va entre corchetes:
Lee https://uniamos.com/playbooks/enriquecer-directorio y sigue este playbook con mi base de [tipo de negocio] (adjunto el Excel).La página para Claude, con todas las instrucciones, está en uniamos.com/playbooks/enriquecer-directorio.
La idea: un foso que nadie puede copiar
Si tu competencia tiene el mismo dataset que tú, tiene las mismas fichas. Pero si extraes de la web de cada negocio los atributos que la gente busca, tienes dos cosas que ellos no: fichas mejores y páginas «X por tipo» («cafeterías pet friendly en Ciudad de México»). Y es honesto: cada dato sale de lo que el propio negocio publica, con la fuente citada.
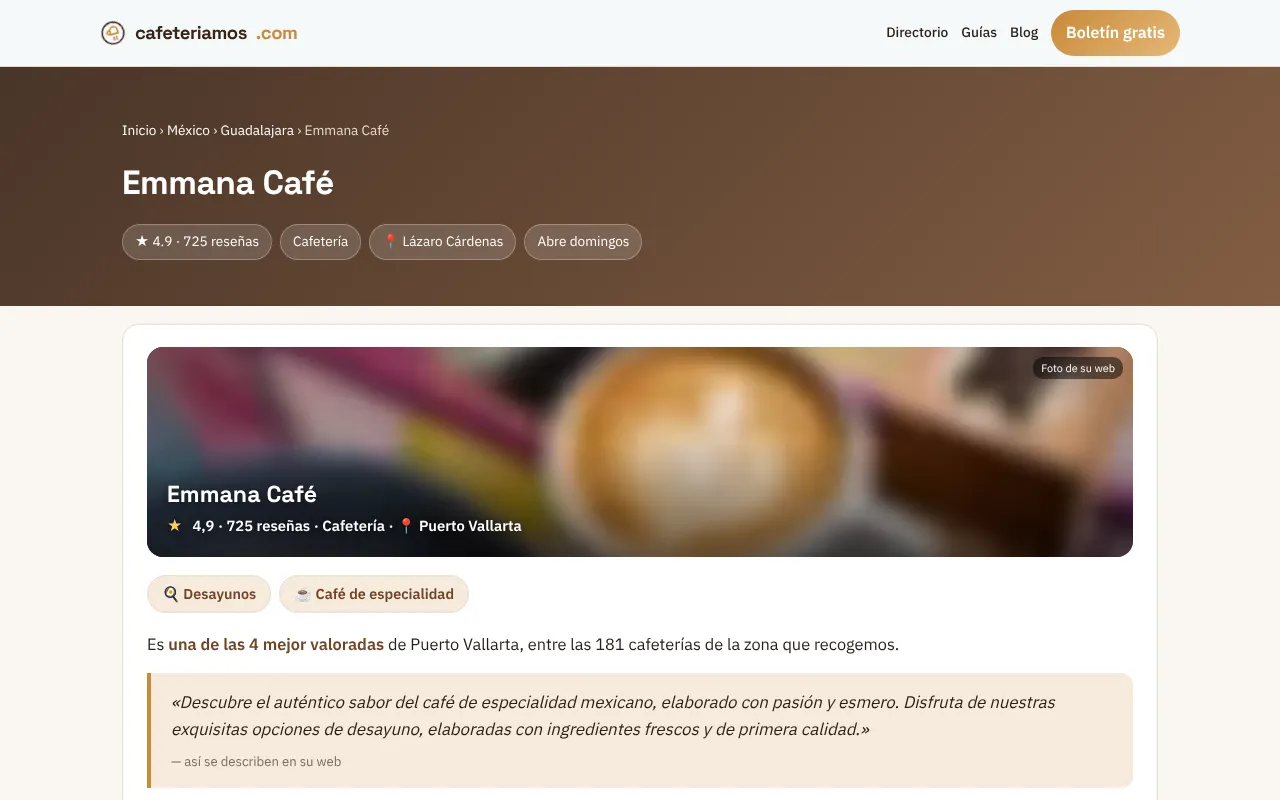
Regla que manda: un atributo solo se marca si la web lo dice. En la ficha aparece como «según su web».
Quién descarga las webs, y por qué tú
Claude no puede descargar miles de webs desde su entorno: solo de una en una y despacio. Common Crawl tampoco basta, porque de un negocio pequeño suele guardar poco más que la portada, y a veces trae webs hackeadas.
La solución: una herramienta que Claude escribe y tú ejecutas con un doble clic en tu ordenador. Tu máquina descarga, con su conexión, y produce un CSV. Unas horas para unas dos mil webs, sin depender de nadie.
Alternativa: pedirle al proveedor de datos que incluya la descripción o el texto de la web de cada negocio en el mismo archivo, junto con reseñas y email, cruzable por el identificador de lugar.
El scraper: qué hace y qué extrae
- Lee las webs del Excel, filtrando por calidad (valoración y reseñas) y saltándose redes sociales y cadenas.
- Descarga la portada de cada una con educación: se identifica, hace pausas, respeta robots.txt y usa pocos hilos.
- Extrae descripción (meta), email, atributos del sector, servicios o métodos y una señal de si el negocio es realmente del tipo que dice el dataset.
- Descarta las webs con spam o hackeadas.
- Escribe un CSV con identificador, nombre, web, estado, descripción, email, atributos, métodos y validez.
- Es reanudable (lo paras y sigue) y se puede repetir sin duplicar.
Se entrega con un lanzador de doble clic que instala lo necesario, encuentra el Excel, ejecuta el scraper y deja el CSV. Cero terminal.
La línea que no puede faltar: import socket; socket.setdefaulttimeout(15) al principio del script. La comprobación de robots.txt de Python no tiene tiempo límite y, si un servidor no contesta, el scraper se queda colgado para siempre. Nos costó una hora descubrirlo.
Atributos para cafeterías (cambia la lista para tu sector):
ATRIBUTOS = {
  "terraza":      ["terraza", "patio", "jardín", "rooftop", "al aire libre"],
  "wifi":         ["wifi", "wi-fi"],
  "trabajar":     ["para trabajar", "coworking", "enchufes", "laptop friendly"],
  "pet_friendly": ["pet friendly", "perros bienvenidos", "admitimos mascotas"],
  "sin_gluten":   ["sin gluten", "gluten free", "celíaco"],
  "vegano":       ["vegano", "vegan", "plant based"],
  "desayunos":    ["desayuno", "brunch"],
  "especialidad": ["café de especialidad", "specialty coffee", "tueste propio"],
}
METODOS = ["v60", "chemex", "aeropress", "prensa francesa", "cold brew", "espresso"]
Para un directorio de psicólogos serían «online», «infantil», «parejas», «EMDR»; para talleres, «grúa», «coche de cortesía», «eléctricos».
Cómo se enriquecen las fichas
Claude usa tres piezas:
- Extractor: del HTML o del texto del CSV saca email, descripción, atributos, métodos, validez y spam.
- Enriquecedor: convierte eso en un bloque de ficha con etiquetas de colores por atributo, la descripción del propio negocio, sus métodos o especialidades, los atributos en prosa («según su propia web, tiene terraza y admite mascotas»), el email y una nota de fuente («datos tomados de la web del propio negocio; si algo cambió, escríbenos»).
- Cruce: identificador de lugar del CSV → coordenadas del Excel → ficha (las fichas llevan sus coordenadas en el JSON-LD). Solo toca las que faltan, arregla los acentos rotos («café» → «café») y se salta los negocios que no son del tipo correcto.
Las páginas por atributo
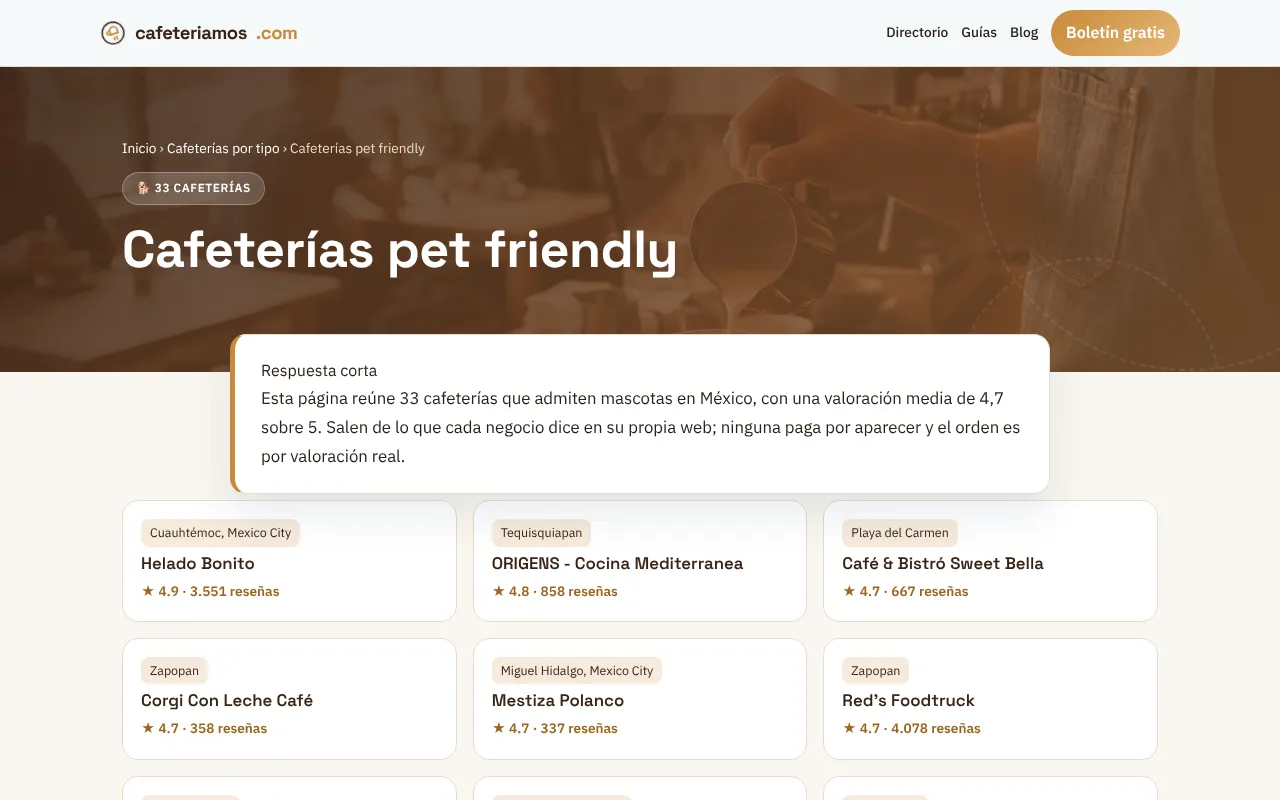
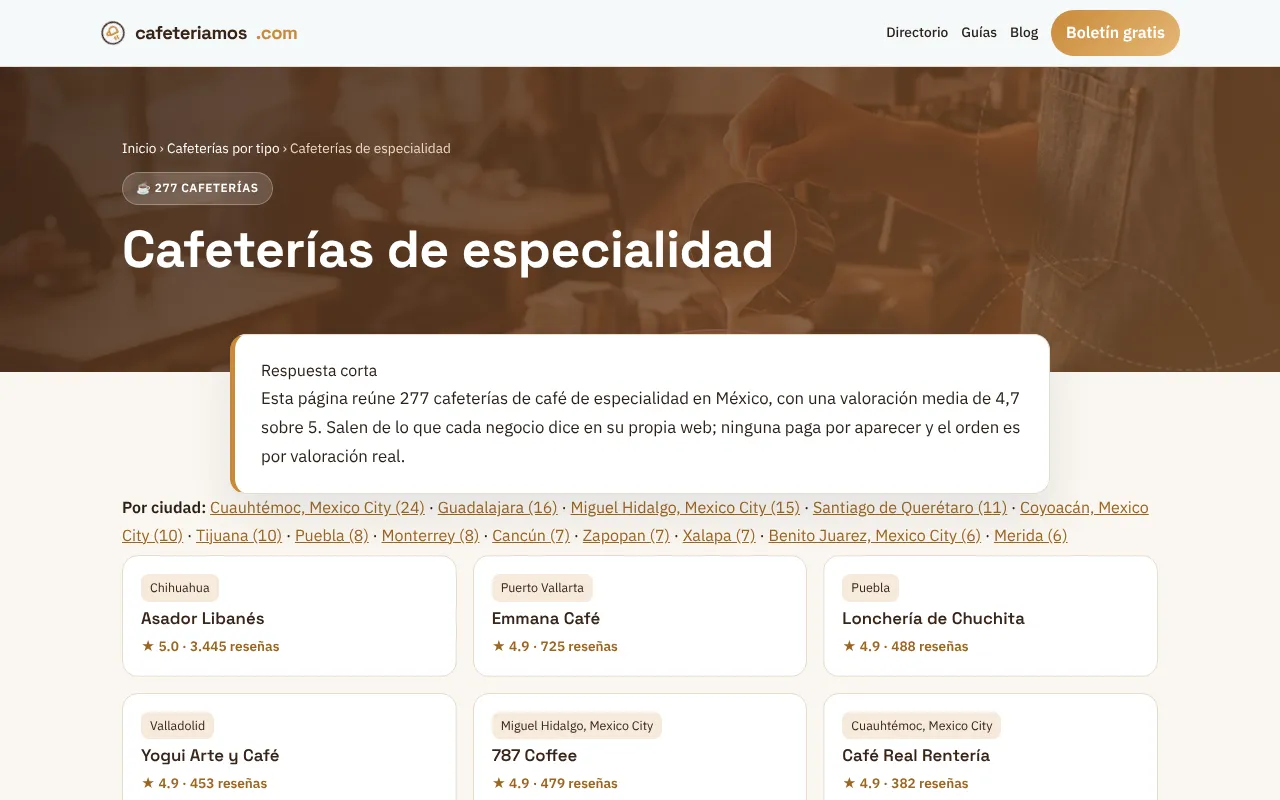
- Nacional: una por atributo (/cafeterias/pet-friendly/, /cafeterias/para-trabajar/…), con todos los negocios que lo tienen, ordenados por valoración real, con cabecera, respuesta corta citable, CollectionPage + ItemList y FAQ.
- Por ciudad: solo donde el número supera el umbral.
- Un hub (/cafeterias/) que enlaza todas.
Umbrales: nacional con 8 a 15 negocios o más, por ciudad con 6 o más. Son más bajos que los de las guías normales porque los atributos son escasos y valiosos, pero nunca tan bajos como para publicar una lista de tres.
Agrupar para que sume: terraza + patio + jardín + azotea → «al aire libre»; wifi + para trabajar → «para trabajar».
Navegación: cada etiqueta de una ficha enlaza a su página. Clic en «Pet friendly» y ves todas las pet friendly. Y el menú gana una entrada «Por tipo».
Automatizarlo
Como el scraper se ejecuta por tandas, una tarea programada diaria se encarga del resto:
- Lee el CSV, que crece a medida que dejas correr el scraper.
- Enriquece las fichas pendientes.
- Regenera las páginas por atributo, así las listas crecen solas.
- Despliega e indexa (IndexNow y cola de Search Console).
El token de despliegue vive en un fichero de secretos de tu ordenador, nunca en el chat.
Avisos honestos
- El scraper lo ejecutas tú, bajo tu responsabilidad. Es información que los negocios publican, para un directorio: uso razonable.
- Emails: si luego los usas para contactar, atención a la normativa (RGPD en Europa, LFPDPPP en México). Mejor emails que el negocio publica y una baja clara; nada de comprar listas para enviar en frío.
- Cobertura parcial: solo dan datos los negocios con web decente, que suelen ser menos de la mitad. El resto se queda con la ficha base, y no pasa nada.
- Los atributos por zona son escasos: casi todo funciona a nivel nacional; por ciudad, solo en las grandes.
- Ruido: la web destapa negocios mal clasificados (un rancho etiquetado como cafetería). Aprovecha para limpiarlos.
- Verifica en producción con curl, no con el navegador, y no despliegues una copia local desfasada.
Siguiente paso: fotos y resumen de reseñas para que cada ficha parezca la web del negocio.
Si prefieres que lo montemos contigo o adaptarlo a tu empresa, es lo que hacemos en las mentorías y formaciones con Claude de Uniamos. Y si quieres hablarlo antes, Marcelo te hace un diagnóstico gratuito de 30 minutos: vemos si tiene sentido y, si no encaja, lo dejamos ahí.
Serie: los playbooks de Uniamos con Claude. Son los que usamos en nuestras mentorías. Ver la guía de playbooks.
- CRM, PRM y bandeja de emails dentro de Claude
- Prospección en LinkedIn con un motivo
- Enviar emails desde Gmail con Claude
- Auditoría SEO y keywords del sector
- La fábrica diaria de posts SEO + GEO
- Subir la autoridad del dominio (DA/DR)
- La fábrica de webs de nicho
- Fotos con IA para tu web
- Base de negocios con Common Crawl y OpenStreetMap
- Enriquecer un directorio con la web de cada negocio (estás aquí)
- Fotos y reseñas en las fichas
- Tareas programadas de Claude
- Tu primer libro con Claude en Amazon KDP
Preguntas frecuentes
¿Por qué no lo descarga Claude directamente?
Claude no puede descargar miles de webs desde su entorno. Por eso escribe un scraper que ejecutas tú con doble clic: tu ordenador descarga y Claude procesa el CSV.
¿Qué atributos se pueden sacar?
Los que la gente busca en tu sector y los negocios mencionan en su web. En cafeterías: terraza, wifi, para trabajar, pet friendly, sin gluten, vegano, desayunos, especialidad. En otros sectores, los suyos.
¿Cuántos negocios tendrán datos?
Solo los que tienen web propia decente, que suelen ser menos de la mitad. El resto mantiene la ficha base.
¿Cuándo se crea una página por atributo?
A nivel nacional con 8 a 15 negocios o más; por ciudad, con 6 o más. Nunca una lista de tres.
¿Cómo se evita inventar?
Un atributo solo se marca si la web del negocio lo dice, y aparece como «según su web», con una vía para corregirlo.