Para montar un directorio necesitas una base de negocios: nombre, web, teléfono, email, horarios. Si no la tienes, hay dos fuentes públicas y gratuitas que, combinadas, cubren casi todo: OpenStreetMap y Common Crawl. Esta guía explica cómo las usamos con Claude, con el código, los costes y los límites legales. La escribimos para un directorio de cafeterías, pero sirve para cualquier sector.
Respuesta corta: Common Crawl es un archivo público que rastrea buena parte de la web cada mes y guarda el HTML de cada página. Se descarga por HTTPS sin cuenta de AWS. Claude localiza las páginas de tus dominios en el índice, descarga solo esas por rango de bytes y extrae email, teléfono, dirección, horarios, redes y una puntuación que dice si el negocio es del sector. Combinado con OpenStreetMap (el universo geográfico) te da una base completa por 0 €.
El enlace para tu Claude
Abre una conversación nueva y pega esto, cambiando lo que va entre corchetes:
Lee https://uniamos.com/playbooks/common-crawl y ayúdame a sacar una base de [tipo de negocio] en [país o ciudades] para mi directorio.La página para Claude, con todas las instrucciones, está en uniamos.com/playbooks/common-crawl.
Qué es Common Crawl
Una organización sin ánimo de lucro que publica cada mes un rastreo de miles de millones de páginas web. Cada crawl tiene varios formatos:
| Formato | Qué contiene | Para qué lo usamos |
|---|---|---|
| WARC | La respuesta HTTP completa, con el HTML | Extraer contactos y datos |
| WAT | Metadatos: enlaces, cabeceras | No lo necesitamos aquí |
| WET | Solo texto plano | Clasificar por palabras, si no hace falta el HTML |
| Índice CDX | Qué URL está en qué WARC y en qué byte | Localizar antes de descargar |
La lista de crawls está en https://index.commoncrawl.org/collinfo.json.
Cómo se accede (sin cuenta de AWS)
https://data.commoncrawl.org/<ruta>          ← endpoint público (límite ~5-10 peticiones/s)
https://commoncrawl.s3.amazonaws.com/<ruta>  ← acceso directo al bucket
Si superas el límite del endpoint público te bloquean unos minutos. Para ir rápido de verdad se usa una máquina pequeña en la misma región que el archivo, donde no hay límite práctico, y el proceso entero cuesta menos de un dólar.
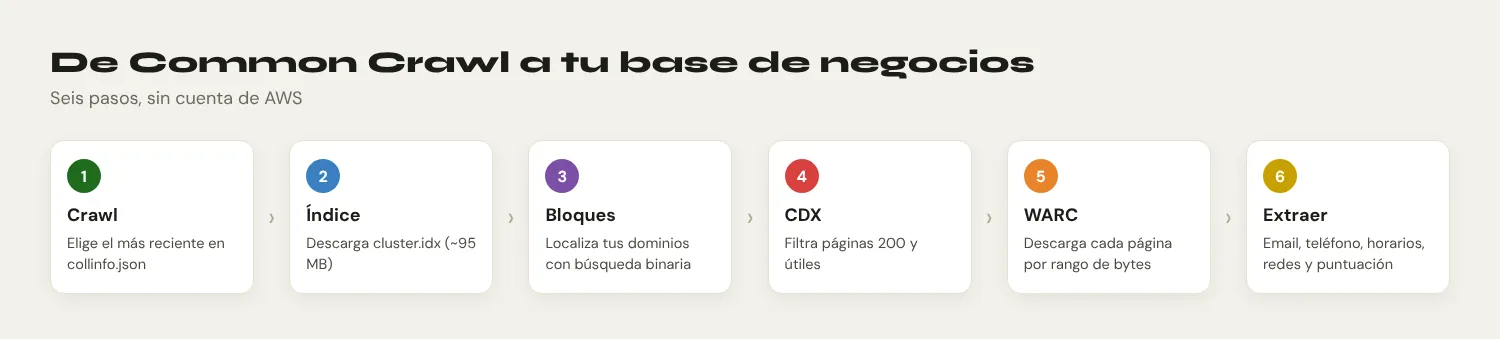
El pipeline en seis pasos
1. Elegir el crawl más reciente
curl -s https://index.commoncrawl.org/collinfo.json | head -20
# → CC-MAIN-2026-XX
2. Descargar el índice de bloques
CRAWL=CC-MAIN-2026-XX
BASE=https://data.commoncrawl.org/cc-index/collections/$CRAWL/indexes
curl -o cluster.idx "$BASE/cluster.idx"     # unos 95 MB
Cada línea apunta al inicio de un bloque del índice (unos 200 KB) con este formato: URL invertida, fecha, fichero, posición, longitud. La URL invertida se llama SURT: www.cafexyz.es se guarda como es,cafexyz)/.
3. Localizar los bloques de tus dominios
Dos estrategias. A: todo un dominio de país (.es, .mx) y filtrar luego por palabras del sector. B: si ya tienes una lista de dominios candidatos (de OpenStreetMap, un directorio, Google Maps), buscarlos uno a uno con búsqueda binaria. La B es mucho más rápida y barata.
from bisect import bisect_left
entries = []
for line in open("cluster.idx"):
    p = line.rstrip("\n").split("\t")
    if len(p) < 4: continue
    entries.append((p[0].split(" ")[0], p[1], int(p[2]), int(p[3])))
surts = [e[0] for e in entries]

for dom in ["cafexyz.es", "otracafeteria.es"]:
    pref = ",".join(reversed(dom.split("."))) + ")"
    i = bisect_left(surts, pref)
    # entries[i-1] y entries[i] cubren el bloque que contiene ese dominio
4. Descargar y filtrar los bloques del índice
curl -H "Range: bytes=<offset>-<offset+length-1>" -o block.gz "$BASE/<shard.gz>"
gunzip -c block.gz | grep "es,cafexyz)"
Cada línea trae un JSON con la URL, el fichero WARC, la posición y la longitud. Te quedas con las que tienen status 200, son text/html y tienen una ruta útil: /, /contacto, /nosotros, /carta, /menu, /horarios, /donde-estamos, /reservas.
5. Descargar cada página
curl -H "Range: bytes=<offset>-<offset+length-1>" -o page.warc.gz \
  "https://data.commoncrawl.org/<warc_filename>"
Se descomprime con la librería warcio de Python. Concurrencia recomendada: 10 a 15 hilos desde fuera de AWS; más de 150 desde dentro.
6. Extraer y clasificar
En la siguiente sección.
Qué se extrae y cómo se clasifica
Con selectolax (mucho más rápido que BeautifulSoup):
- Emails con una expresión regular, validando que el dominio del email coincide con el de la web.
- Teléfonos con la librería phonenumbers y la región del país.
- Dirección por códigos postales y nombres de provincia.
- Nombre del JSON-LD (LocalBusiness, Restaurant, CafeOrCoffeeShop) y, si no hay, del
<title>. - Horarios (
openingHours) y coordenadas (geo) del JSON-LD. - Redes: enlaces a Instagram, Facebook y TikTok.
Clasificación por puntuación. Cada web suma puntos por palabras del sector. Para cafeterías:
café, cafetería, coffee shop, especialidad, specialty coffee, tostador, brunch,
latte, espresso, cappuccino, flat white, V60, chemex, aeropress, single origin,
barista, granos, torrefacción, blend, arábica
Y puntos extra por señales fuertes: que declare el tipo CafeOrCoffeeShop de schema.org, frases como «café de especialidad» o certificaciones del sector. Para otro sector solo cambias la lista.
El fichero que obtienes
| Campo | Ejemplo |
|---|---|
| dominio | cafexyz.es |
| nombre | Café XYZ |
| tipo | Especialidad / tradicional / cadena / café-coworking |
| ciudad, provincia, dirección, CP | Barcelona · Carrer Exemple 123 · 08008 |
| teléfono | +34 900 000 000 |
| hola@cafexyz.es | |
| horarios | L-V 8-20, S-D 9-18 |
| instagram, facebook | @cafexyz |
| coordenadas | 41.39, 2.15 |
| puntuación y palabras detectadas | 8 · specialty; V60; brunch |
| url_fuente | La página de donde salió cada dato |
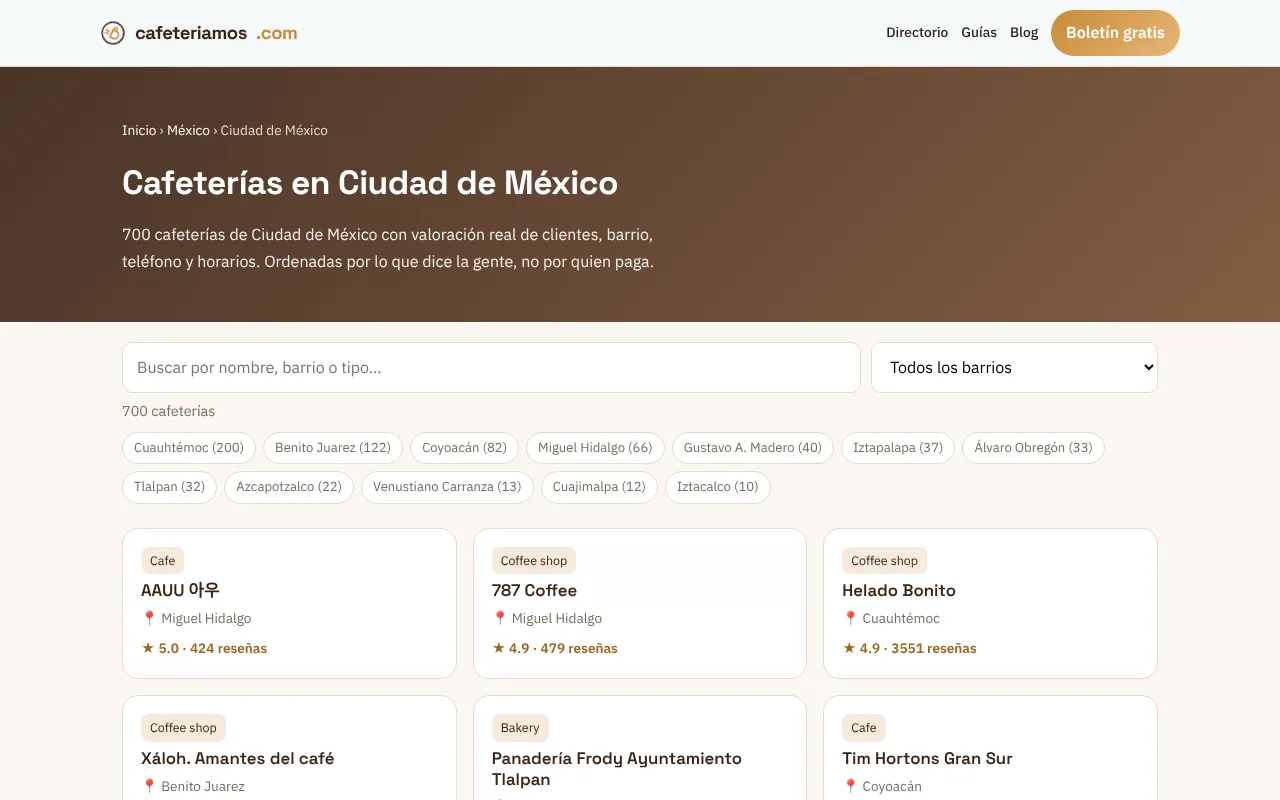
Con este método sacamos en su día cerca de cinco mil empresas industriales mexicanas con datos de contacto públicos. Y con datos así se montan directorios como el de cafeteriamos.com.
OpenStreetMap y otras fuentes
- OpenStreetMap tiene casi todos los negocios etiquetados por tipo (
amenity=cafe) y con coordenadas. Se consulta gratis con la API Overpass y suele dar mejores datos geográficos que Common Crawl. Empieza por aquí. - APIs de lugares de pago (Google Places, Foursquare): calidad muy alta, cuestan por consulta.
- Instagram: en sectores como el café de especialidad, mucha actividad con ubicación.
Nuestra recomendación: OpenStreetMap para el universo geográfico y Common Crawl para la web, el email, la descripción y la carta. Juntos dan más que cualquiera por separado.
[out:json][timeout:60];
area["name"="Barcelona"]["admin_level"="8"]->.a;
node["amenity"="cafe"](area.a);
out body;
Coste y tiempo
| Opción | Coste | Tiempo orientativo |
|---|---|---|
| Desde el entorno de Claude, respetando el límite | 0 € | 4-6 horas |
| Máquina en la región del archivo | Menos de 1 USD | 30-45 minutos |
| API de lugares de pago para 2.000 negocios | Unas decenas de dólares | 30 minutos |
| OpenStreetMap + Common Crawl | 0 € | 1-2 horas |
Legalidad: qué emails sí y cuáles no
Los emails genéricos que el negocio publica en su web (info@, hola@) para un directorio comercial B2B son razonables bajo interés legítimo, con una forma clara de darse de baja. Los personales (nombre.apellido@) requieren más cuidado: mejor no usarlos para enviar emails en frío y limitarlos, como mucho, a un contacto para incluirlos en el directorio. Si el directorio es solo informativo (mostrar el negocio, sus datos y su web) y no envías nada, es un caso claramente admisible. Revisa siempre la normativa de tu país; esto no es asesoramiento legal.
Límites honestos
- Common Crawl es fino con los negocios pequeños: a menudo solo guarda la portada.
- A veces trae webs hackeadas con spam (casinos, apuestas): hay que descartarlas.
- La cobertura depende del país y del sector; un piloto de 500 dominios te dice enseguida si merece la pena.
- Para negocios sin web, Common Crawl no aporta nada: ahí manda OpenStreetMap o un proveedor de datos.
Siguiente paso: enriquecer las fichas con la web de cada negocio para tener atributos que nadie más tiene.
Si prefieres que lo montemos contigo o adaptarlo a tu empresa, es lo que hacemos en las mentorías y formaciones con Claude de Uniamos. Y si quieres hablarlo antes, Marcelo te hace un diagnóstico gratuito de 30 minutos: vemos si tiene sentido y, si no encaja, lo dejamos ahí.
Serie: los playbooks de Uniamos con Claude. Son los que usamos en nuestras mentorías. Ver la guía de playbooks.
- CRM, PRM y bandeja de emails dentro de Claude
- Prospección en LinkedIn con un motivo
- Enviar emails desde Gmail con Claude
- Auditoría SEO y keywords del sector
- La fábrica diaria de posts SEO + GEO
- Subir la autoridad del dominio (DA/DR)
- La fábrica de webs de nicho
- Fotos con IA para tu web
- Base de negocios con Common Crawl y OpenStreetMap (estás aquí)
- Enriquecer un directorio con la web de cada negocio
- Fotos y reseñas en las fichas
- Tareas programadas de Claude
- Tu primer libro con Claude en Amazon KDP
Preguntas frecuentes
¿Qué es Common Crawl?
Un archivo público y gratuito que rastrea buena parte de la web cada mes y guarda el HTML de cada página, con un índice para localizarlas.
¿Necesito una cuenta de AWS?
No. Se accede por HTTPS anónimo. El endpoint público tiene un límite de unas 5 a 10 peticiones por segundo; para ir más rápido se usa una máquina en la misma región, por menos de un dólar.
¿Qué datos se pueden sacar?
De las páginas de cada negocio: emails del propio dominio, teléfonos, dirección, nombre, horarios, coordenadas y redes sociales, más una puntuación que dice si es del sector.
¿Por qué combinarlo con OpenStreetMap?
OpenStreetMap da el universo geográfico (qué negocios hay y dónde) y Common Crawl aporta la web, el email y la descripción. Juntos son más completos que cualquiera por separado.
¿Es legal usar esos emails?
Los genéricos que publica el negocio, para un directorio B2B con baja clara, suelen ser razonables. Los personales, no para enviar en frío. Revisa la normativa de tu país; no es asesoramiento legal.